雲端大模型明明更聰明,我們為什麼還要鑽研 0.8B 和 4B 本機轉寫小模型?
每次我們跟同行聊起「我們在自己訓練 0.8B 和 4B 的輸入法本機轉寫小模型」時,大家最常問的一個問題就是:現在雲端大模型已經這麼強了,只要把提示詞工程(Prompt Engineering)做好,大模型肯定比小模型更準,幹嘛還要費盡周折自己訓練小模型?
直接把結論擺在檯面上:沒錯,論純粹的語言理解能力,配好提示詞工程的雲端大模型絕對全面強於本機小模型。 一句話裡要是摻雜了極其微妙的多語言混合意圖、同音詞歧義,或者需要做開放式的語氣潤飾(Polish)與語境解釋(Explain),雲端大模型擁有小模型望塵莫及的參數量與世界知識;而且在手機上打字時,把推論放在雲端意味著手機本機零發燙、零額外耗電。這也是為什麼在 UnimeType 的日常體驗裡,Polish、Explain 以及追求最高複雜意圖準確率的雲端 Convert 依然堅定地由雲端大模型驅動。
那我們為什麼還要花大力氣鑽研 UnimeType Transliteration 2.0(v2.1 / 2.0-v4,含 0.8B 與 4B 兩個開源尺寸)?因為小模型有兩個雲端永遠無法替代的殺手鐧:100% 離線運作的絕對隱私保護(草稿哪怕一個位元組都不出本機 127.0.0.1),以及零網路往返的超低本機延遲。這篇復盤就誠實地攤開聊聊:當我們為了離線隱私與低延遲把模型壓縮到 4B 和 0.8B 時,小模型在複雜混合語言意圖與硬體功耗(PC/Mac vs 手機電量與發熱)上的真實物理邊界在哪,以及我們是如何評測並打磨這顆本機專用轉寫小模型的。
模型選型與尺寸邊界
1.1 雲端大模型與本機專用小模型的真實邊界
在輸入法裡做整句拉丁轉寫(比如把 mingtian 3pm gen @alex review auth-service de PR #412, ranhou deploy dao staging 原地轉成母語文字並保留全部英文程式碼識別字),傳統輸入法、雲端大模型與本機專用小模型站在完全不同的物理象限上:
- 傳統即時候選字視窗輸入法(macOS 內建注音/拼音、Rime 鼠鬚管、Google Japanese Input / Mozc、Gboard、Windows 微軟注音/拼音)在敲擊每個字母時透過本機詞格即時攔截按鍵,寫純單一母語最快,但一旦句子裡夾雜
useEffect、kubectl或PR #412,來回按Caps Lock或Shift切模式就會頻繁打斷思路甚至吞掉字母。 - 配好提示詞工程的雲端大模型(理解上限最高,且專責
Polish/Explain):只要做好嚴格的提示詞工程與受保護片段(Protected Spans)約束,雲端大模型是處理複雜混合語言意圖最強的大腦,它能結合廣泛的上下文分清一句話裡的英文詞到底是借詞、程式碼變數還是未寫完的拼音;同時,像Polish(潤飾改寫語氣) 和Explain(解釋生僻俚語或縮寫) 這類需要深度語意推論與長文本組織能力的動作,只有雲端大模型才能勝任。 - 本機專用小模型(
0.8B/4B)的核心價值與天然限制:- 為什麼需要本機小模型:許多開發者和重視隱私的使用者希望日常按
Convert時文字完全留在本機(離線可用、零網路請求),且不希望每次按鍵都攜帶上千 Token 的冗長系統提示詞拖慢首字延遲(TTFT)。 - 為什麼小模型必須專門微調:大模型靠一段精心設計的系統提示詞就能聽懂「只轉寫拼音、不翻譯英文、不輸出寒暄」;但未經微調的
0.8B或4B小模型如果直接跑零系統提示詞短協定(unimetype-convert-short-v3),通過率只有慘淡的11.0%~21.3%,經常把轉寫當成翻譯、漏轉阿拉伯語數字,或者改壞英文技術詞。只有把轉寫契約透過高強度 SFT + DPO 直接烙進權重裡,小模型才能在零提示詞開銷下秒級工作。 - 誠實面對小模型的能力天花板:即便經過專門訓練,
0.8B與4B小模型依然受限於參數量,它們只能做好邊界高度確定的Convert(拉丁轉寫)這一件事,無法處理更複雜的Polish與Explain;而且在極其刁鑽的跨語種模糊意圖判斷上,依然無法取代雲端大模型。
- 為什麼需要本機小模型:許多開發者和重視隱私的使用者希望日常按
1.2 基底模型家族橫評(零系統提示詞短協定下的 Qwen3.5 vs Gemma 3 vs Phi-4-mini)
為了讓本機模型在省去冗長系統提示詞(Zero-System-Prompt Short Protocol)的前提下依然能極速回應,我們在 127 例多語言先導集與 414 例標準測試集上,對比了各大開源小模型基底在微調前後的收斂上限(註:表中 DeepSeek V4.1 Flash 為不帶完整長系統提示詞、直接裸跑相同短協定的零樣本對照,旨在測試模型內化短協定的差異,不代表設定完整提示詞後的雲端大模型上限):
| 基底家族與模型版本 | 參數量與層數 | 127 例先導集(未微調基底) | 127 例先導集(相同 LoRA 配方) | 414 例 v4 標準集(短協定 Strict Pass) | 核心語言學與工程表現對比 |
|---|---|---|---|---|---|
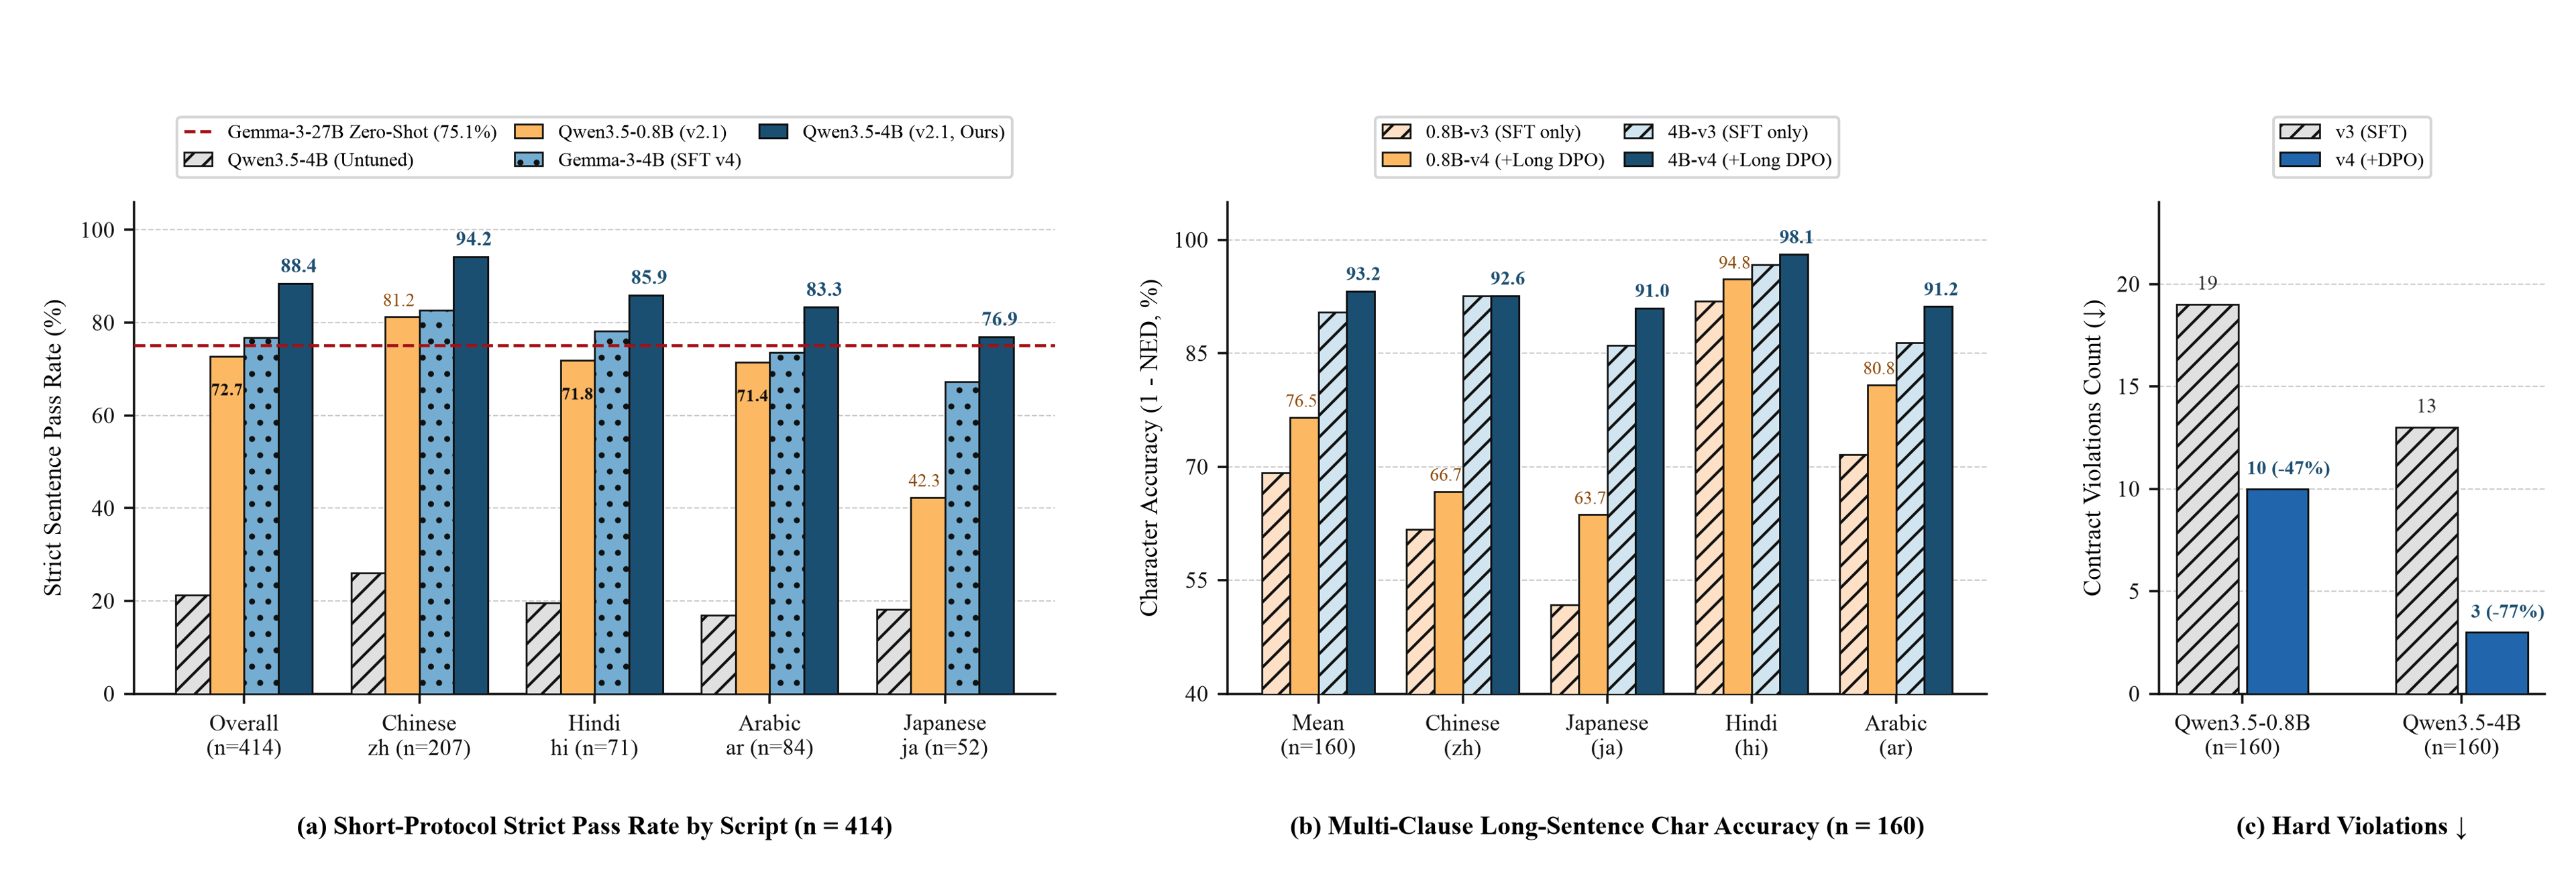
Qwen/Qwen3.5-4B(Transliteration-2.0-4B-v4) | 4.0B(32 層) | 27 / 127(21.3%) | 96 / 127(75.6%) | 366 / 414(88.4%) | 中日文同音字消歧與漢字假名邊界最強;全層 BF16 微調後印地語(85.9%)與阿拉伯語(83.3%)同步領跑 |
Qwen/Qwen3.5-0.8B(Transliteration-2.0-0.8B-v4) | 0.8B(24 層) | 14 / 127(11.0%) | 78 / 127(61.4%) | 301 / 414(72.7%) | 最佳超輕量級基底;<600 MB 體積即可完成常見短句離線轉寫,但長句複雜意圖仍受限於 0.8B 容量 |
| DeepSeek V4.1 Flash(無長提示詞·短協定零樣本對照) | 雲端模型(裸跑短協定) | — | — | 292 / 414(70.5%) | 僅作無長系統提示詞的零樣本參照;若在雲端配齊完整提示詞工程,雲端大模型在複雜混打意圖上明顯更強 |
| google/gemma-3-4b-it | 4.0B | 29 / 127(22.8%) | 84 / 127(66.1%) | 318 / 414(76.8%) | 印地語與阿語原始底子略好,但中文無空白連打拼音切分與日文複合漢字準確率明顯落後於 Qwen3.5 |
| google/gemma-3-27b-it(未微調大參數對照) | 27.0B | 94 / 127(74.0%) | — | 311 / 414(75.1%) | 零樣本上限高,但需 >16 GB 記憶體且單句延遲達 3.4s,無法作為本機常駐輸入法模型 |
| google/gemma-3-1b-it | 1.0B | 11 / 127(8.7%) | 63 / 127(49.6%) | 241 / 414(58.2%) | 日文助詞與阿拉伯語詞尾頻繁漏轉或發生跨文字干擾 |
| microsoft/Phi-4-mini-instruct | 3.8B | 19 / 127(15.0%) | 71 / 127(55.9%) | 269 / 414(65.0%) | 英文程式碼段保護能力極穩,但天城文與阿拉伯字母的音素映射表徵較弱 |
為什麼最終選定 Qwen3.5 作為唯一雙尺寸基底?
- 決定性的中日文(CJK)詞彙先驗:中文無聲調拼音轉國字、日文羅馬字轉漢字假名混寫(Kanji-Kana)高度依賴基底對上下文語意與同音詞搭配的先驗知識,
Qwen3.5在中文(94.2%)與日文(76.9%)上遠超同尺寸Gemma 3與Phi-4-mini。 - 在天城文與阿拉伯文上的高可塑性:雖然未微調的
gemma-3-4b-it在 127 例先導集上比未微調的Qwen3.5-4B多對 2 題(29vs27),但經過全 32 層原生 BF16 LoRA SFT + DPO 後,Qwen3.5-4B在印地語(85.9%)和阿拉伯語(83.3%)上實現了大幅反超。
1.3 為什麼必須分 0.8B 和 4B(PC/Mac 與手機端的記憶體、電量與發熱鐵律)
很多沒做過終端裝置應用的工程師會問:既然 4B 比 0.8B 準得多(標準集 88.4% vs 72.7%,長句字元準確率 93.21% vs 76.49%),為什麼不乾脆所有裝置都塞一顆 4B 模型?
答案很簡單:PC/Mac 桌面端和手機端(iOS / Android)能承受的模型量級,隔著一道由記憶體上限、電池容量和被動散熱決定的物理鐵幕。
- PC / Mac 桌面端(
4B的主場):MacBook 和桌上型 PC 擁有充裕的統一記憶體/顯示記憶體(16 GB~64 GB)、大容量電池或外接電源,以及更強的散熱裕度。在 Apple Silicon Mac 的 LM Studio 裡常駐一顆~2.57 GB的Transliteration-2.0-4B(或~564 MB的0.8B),單句推論只需0.2s~0.6s,既能獲得接近雲端的一般句子轉寫品質,又不會帶來肉眼可見的續航焦慮。 - 手機端 iPhone / Android(嚴酷的電量、發熱與記憶體紅線):手機輸入法是一個一天要被喚醒幾百次的高頻底層元件。第一,iOS 鍵盤擴充功能(Keyboard Extension)有極其嚴苛的系統記憶體沙盒上限,塞入數 GB 的
4B權重會直接被系統 OOM 強制終止;第二,哪怕是輕量的本機模型,如果在手機 NPU/GPU 上頻繁跑自迴歸生成,只要連續聊十幾分鐘 LINE 或 WhatsApp,手機背蓋就會明顯發燙、電量肉眼可見地往下掉,沒有任何使用者會容忍一個讓手機變暖暖包的輸入法。因此,0.8B是針對低記憶體輕薄筆電與終端極限功耗場景探索的超輕量檔位;而在手機日常高頻使用、遇到複雜多語種混合意圖、或者需要Polish與Explain時,直接呼叫做好提示詞工程的雲端大模型(手機本機零算力消耗、零發燙、不佔記憶體、理解力最強)反而才是最合理的工程解。
| 對比維度 | Transliteration-2.0-0.8B (v2.1) | Transliteration-2.0-4B (v2.1) | 雲端大模型(完整提示詞工程) / 27B+ |
|---|---|---|---|
| 基底與運作方式 | Qwen/Qwen3.5-0.8B(本機離線短協定) | Qwen/Qwen3.5-4B(本機離線短協定) | 雲端大模型 API(含完整系統提示詞) |
| 本機磁碟與記憶體佔用 | ~564 MB (MLX 6-bit) / ~530 MB (Q4_K_M) | ~2.57 GB (MLX 6-bit) / ~4.28 GB (Q8_0) | 本機 0 MB(雲端承擔算力) |
| 裝置電量與發熱影響 | 低(適合輕薄筆電與低功耗終端) | 中(適合供電與散熱充裕的 PC / Mac) | 手機/電腦本機零發燙、零額外耗電 |
複雜混合語言意圖 & Polish / Explain | 僅限基礎 Convert(複雜長句易受容量限制,不支援 Polish/Explain) | 勝任絕大多數日常與技術 Convert(不支援開放式 Polish/Explain) | 最強(精準理解複雜混打意圖,完整支援 Convert / Polish / Explain) |
| 414 例短協定測試集通過率 | 301 / 414(72.7%) | 366 / 414(88.4%) | 雲端完整提示詞下為能力上限基線 |
| 160 例多子句長句字元準確率 | 76.49%(印地語達 94.77%) | 93.21%(四語種均 >90.9%) | 雲端完整提示詞下長句穩定度最高 |
| 單句平均推論延遲(Apple M3 Max) | ~0.19s(本機零網路開銷) | ~0.61s(本機零網路開銷) | 取決於網路往返與雲端並行 |
| 最佳適用定位 | 8 GB 記憶體輕薄筆電、對體積與功耗敏感的本機離線 Convert | 16 GB+ Mac / PC 在 LM Studio 跑 100% 離線高準度 Convert | 行動端主力(不發燙不耗電)、複雜混打意圖、以及全部 Polish / Explain 動作 |
資料集與兩階段訓練
2.1 為什麼放棄翻譯語料並自建真實混打評測基準
訓練轉寫模型最容易踩的坑,是直接拿公開的機器翻譯平行語料(如 OPUS、WMT、字幕語料)把目標語言用腳本自動轉成拼音或羅馬字。這種合成資料在真實打字場景下會全面崩盤,原因有四點:
- 真實使用者的輸入是非規範簡寫:使用者會輸入無空白連打拼音(
mingtianshangwu)、按詞組連寫的日文羅馬字(ashitatokyode)、口語化 Hinglish(kal milte hain)以及帶數字諧音的阿拉伯語 Arabizi(7abibi、3amel、bta3)。 - 真實訊息裡的英文是故意保留的:在
qing bang wo review auth-service de PR #412中,review、auth-service和PR #412是使用者明確不想轉換的英文,而qing bang wo和de則必須轉成請幫我和的。 - 多子句長句退化(
v3$\rightarrow$v4的關鍵改進):早期模型在短句上表現尚可,但一旦遇到包含 2~5 個子句(60–240字元)的真實工作訊息,整句嚴格通過率就會出現斷崖式下滑。只有針對多子句長句與跨語種邊界系統性地擴充真實混打分佈,才能讓小模型在長段落裡保持穩定。 - 嚴格的零洩漏評測隔離:我們的 414 例標準測試集與 160 例多子句長句測試集在句式範本與請求指紋上與訓練資料完全隔離,確保評測分數反映真實的泛化能力。
2.2 多子句長句中的注意力漂移與偏好對齊
僅靠監督式微調(SFT)能讓小模型學會基本的音素轉寫,但在 60–240 字元的多子句長句中,自迴歸生成到後半段時依然容易出現注意力漂移,比如在第三個子句後擅自做摘要或漏轉尾部子句、把日文助詞 node(ので)和 to(と)誤判成英文技術詞保留下來、或者把阿拉伯語 Arabizi 詞內的數字諧音與真實時間戳記(3pm)混淆。
為了壓制這些長句退化,我們在第一階段全層監督式微調之後引入了第二階段偏好對齊(DPO)。透過建構正負對比樣本,模型學會了在長句後半段依然嚴格遵守逐子句 1:1 音素對齊、保護英文程式碼與數字字面量、保持原有換行結構,並在使用者觸發「換個候選(reconvert)」時穩定給出不重複的新同音結果。
2.3 為什麼堅持原生 BF16 訓練並預設關閉思考標籤
在模型訓練與打包階段,有兩個直接決定本機體驗的工程取捨:
- 拒絕 4-bit QLoRA 捷徑,全程使用原生 BF16 權重微調:早期實驗表明,在多語種字元邊界高度敏感的轉寫任務上,4-bit QLoRA 量化微調會削弱模型對細微字元邊界(如 Arabizi 數字諧音與真實數字、反引號程式碼段兩側空白)的分辨力。只有基於原生未量化 BF16 權重完成全層訓練,再匯出為推論格式,才能守住多語種轉換的精度下限。
- 預設固化無思考(Non-Thinking)對話範本:
Qwen3.5系列預設開啟<think>思維鏈標籤,但在輸入法場景下,任何額外的思考 token 都會直接拖慢按鍵回應。因此我們在v2.1(2.0-v4)的全部發佈權重中預設關閉了思維鏈輸出,確保在 LM Studio、mlx-lm和llama.cpp中零思考損耗、開箱即用。
2.4 五維自動化評測體系與 v4 完整基準成績單
我們對每一個候選模型同時執行 5 個正交維度的自動化評分:
- 整句嚴格匹配與正規化匹配(Strict & Normalized Sentence Match):與人工核驗的標準參考答案進行逐字比對。
- 字元級準確率(Character-Level Accuracy,
1 - 正規化編輯距離):在60–240字元的多子句長句中,避免因單個標點或同義助詞差異掩蓋整句 95%+ 子句轉換正確的真實品質。 - 受保護片段保留率(Protected Span Preservation):核驗所有英文技術詞、
@handle、URL、CLI 參數與數字字面量是否 100% 原樣保留。 - 文字純淨度(Script Purity):檢測轉換區是否殘留未轉換的拉丁拼音,以及英文保護區是否混入目標語言字元。
- 契約違規計數(Contract Violations):統計改動保留英文、改動數字、改變換行數及重複被拒候選的硬性錯誤次數。
414 例標準短句與邊界測試集結果
| 語種 / 評測切片 | v1.0 (Transliteration-4B) | DeepSeek V4.1 Flash(裸跑短協定對照) | v2.1 (Transliteration-2.0-0.8B-v4) | v2.1 (Transliteration-2.0-4B-v4) |
|---|---|---|---|---|
| 414 例總體嚴格通過率(Strict Pass) | 230 / 414(55.6%) | 292 / 414(70.5%) | 301 / 414(72.7%) | 366 / 414(88.4%) |
| 414 例總體擴展通過率(Expanded Pass) | 242 / 414(58.5%) | 297 / 414(71.7%) | 301 / 414(72.7%) | 366 / 414(88.4%) |
中文拼音(zh,207 例) | 151 / 207(72.9%) | 171 / 207(82.6%) | 168 / 207(81.2%) | 195 / 207(94.2%) |
日文羅馬字(ja,52 例) | 15 / 52(28.8%) | 37 / 52(71.2%) | 22 / 52(42.3%) | 40 / 52(76.9%) |
印地語 Hinglish(hi,71 例) | 41 / 71(57.7%) | 49 / 71(69.0%) | 51 / 71(71.8%) | 61 / 71(85.9%) |
阿拉伯語 Arabizi(ar,84 例) | 23 / 84(27.4%) | 35 / 84(41.7%) | 60 / 84(71.4%) | 70 / 84(83.3%) |
160 例多子句長句基準測試結果
| 語種 / 切片 / 核心指標 | 0.8B-v3(升級前) | 0.8B-v4(v2.1 升級後) | 4B-v3(升級前) | 4B-v4(v2.1 升級後) |
|---|---|---|---|---|
| 160 例長句嚴格整句通過(Strict Pass) | 1 / 160(0.6%) | 13 / 160(8.1% · 提升 13 倍) | 32 / 160(20.0%) | 46 / 160(28.8%) |
| 160 例長句正規化整句通過(Normalized) | 1 / 160(0.6%) | 13 / 160(8.1%) | 33 / 160(20.6%) | 47 / 160(29.4%) |
| 160 例長句平均字元級準確率(Char Acc) | 69.23% | 76.49%(+7.26%) | 90.43% | 93.21%(+2.78%) |
中文長句(zh,40 例) | 61.70% 字元(0/40) | 66.72% 字元(1/40) | 92.57% 字元(6/40) | 92.61% 字元(9/40 · 22.5%) |
日文長句(ja,40 例) | 51.73% 字元(0/40) | 63.66% 字元(1/40) | 86.00% 字元(6/40) | 90.98% 字元(9/40 · 22.5%) |
印地語長句(hi,40 例) | 91.88% 字元(1/40) | 94.77% 字元(11/40 · 27.5%) | 96.72% 字元(20/40) | 98.09% 字元(25/40 · 62.5%) |
阿拉伯語長句(ar,40 例) | 71.62% 字元(0/40) | 80.80% 字元(0/40) | 86.42% 字元(0/40) | 91.18% 字元(3/40 · 7.5%) |
| 切片:雙語技術程式碼混排長句(32 例) | — | 4 / 32(12.5% strict) | — | 17 / 32(53.1% strict) |
| 切片:帶保護佔位符與多行排版(32 例) | — | 2 / 32(6.3% strict) | — | 10 / 32(31.3% norm) |
切片:reconvert 換候選與動態詞庫(32 例) | — | 5 / 32(15.6% strict) | — | 9 / 32(28.1% strict) |
| 160 例總契約違規次數(越低越好) | 19 次 | 10 次(-47.4%) | 13 次 | 3 次(-76.9%) |
本機執行與跑分重現
3.1 官方開源的 6 個 Hugging Face 模型儲存庫(v2.1 / 2.0-v4)
我們將 0.8B 與 4B 的全部三種工業級推論格式以 Apache-2.0 授權開源在 Hugging Face,每個儲存庫均附帶完整的 SHA256SUMS 校驗清單、PROVENANCE.json 溯源帳本與不可變 Git 標籤(v2.1 對應最新多子句長句升級版,v2.0 對應初代短協定版本):
| 模型尺寸與權重格式 | Hugging Face 官方儲存庫連結 | 核心權重檔案與體積 | 適用推論引擎與推薦硬體 |
|---|---|---|---|
4B · Apple Silicon MLX 6-bit | UnimeType/Transliteration-2.0-4B | model.safetensors(~2.57 GB,6-bit affine group_size=64) | LM Studio(macOS MLX 引擎)、mlx_lm、M1–M4 系列 Mac |
4B · GGUF(Q8_0) | UnimeType/Transliteration-2.0-4B-GGUF | Transliteration-4B-Convert-Q8_0.gguf(~4.28 GB) | LM Studio(llama.cpp 引擎)、llama-server、Windows / Linux / macOS |
4B · Standard BF16 Safetensors | UnimeType/Transliteration-2.0-4B-Safetensors | model-00001/00002.safetensors(~8.05 GB 原生 BF16) | transformers、vLLM、SGLang、二次微調與精度複核 |
0.8B · Apple Silicon MLX 6-bit | UnimeType/Transliteration-2.0-0.8B | model.safetensors(~564 MB,6-bit affine group_size=64) | LM Studio(macOS MLX 引擎)、8 GB 記憶體 MacBook 極速常駐 |
0.8B · GGUF(Q4_K_M & Q8_0) | UnimeType/Transliteration-2.0-0.8B-GGUF | Q4_K_M.gguf(~530 MB)與 Q8_0.gguf(~810 MB) | LM Studio(llama.cpp 引擎)、llama-server、輕薄筆電 CPU / 內顯推論 |
0.8B · Standard BF16 Safetensors | UnimeType/Transliteration-2.0-0.8B-Safetensors | model.safetensors(~1.52 GB 原生 BF16) | transformers、vLLM、終端蒸餾與研究評測 |
3.2 在 LM Studio 中載入與啟動本機服務的步驟
- 下載模型權重:
- 開啟 LM Studio $\rightarrow$ Discover(搜尋),輸入
UnimeType/Transliteration-2.0-4B-GGUF(如果你使用的是 Apple Silicon Mac 且啟用了 MLX 引擎,可直接搜尋UnimeType/Transliteration-2.0-4B;8 GB 記憶體裝置推薦下載0.8B版本)。 - 或者直接使用
huggingface-cli下載到 LM Studio 本機模型目錄:# Apple Silicon MLX 6-bit (4B) huggingface-cli download UnimeType/Transliteration-2.0-4B --revision v2.1 \ --local-dir ~/.lmstudio/models/UnimeType/Transliteration-2.0-4B # 跨平台 GGUF Q8_0 (4B) huggingface-cli download UnimeType/Transliteration-2.0-4B-GGUF --revision v2.1 \ --local-dir ~/.lmstudio/models/UnimeType/Transliteration-2.0-4B-GGUF
- 開啟 LM Studio $\rightarrow$ Discover(搜尋),輸入
- 設定確定性解碼參數(關鍵):
- System Prompt(系統提示詞):保持留空(
Transliteration-2.0採用零系統提示詞的精簡 JSON 請求協定,不浪費任何上下文 token)。 - Temperature(溫度):設為
0.0(必須使用貪婪解碼,防止技術識別字或數字發生隨機取樣漂移)。 - Max Tokens(最大生成長度):
256~512(上下文長度Context Length設為1024)。 - Stop Strings(停止詞):
<|im_end|>。
- System Prompt(系統提示詞):保持留空(
- 啟動本機 OpenAI 相容 API 服務:
- 切到 LM Studio 的 Developer / Local Server 分頁,點擊 Start Server(預設監聽位址為
http://127.0.0.1:1234/v1/chat/completions)。
- 切到 LM Studio 的 Developer / Local Server 分頁,點擊 Start Server(預設監聽位址為
3.3 unimetype-convert-short-v3 精簡 JSON 請求協定與四語種實測範例
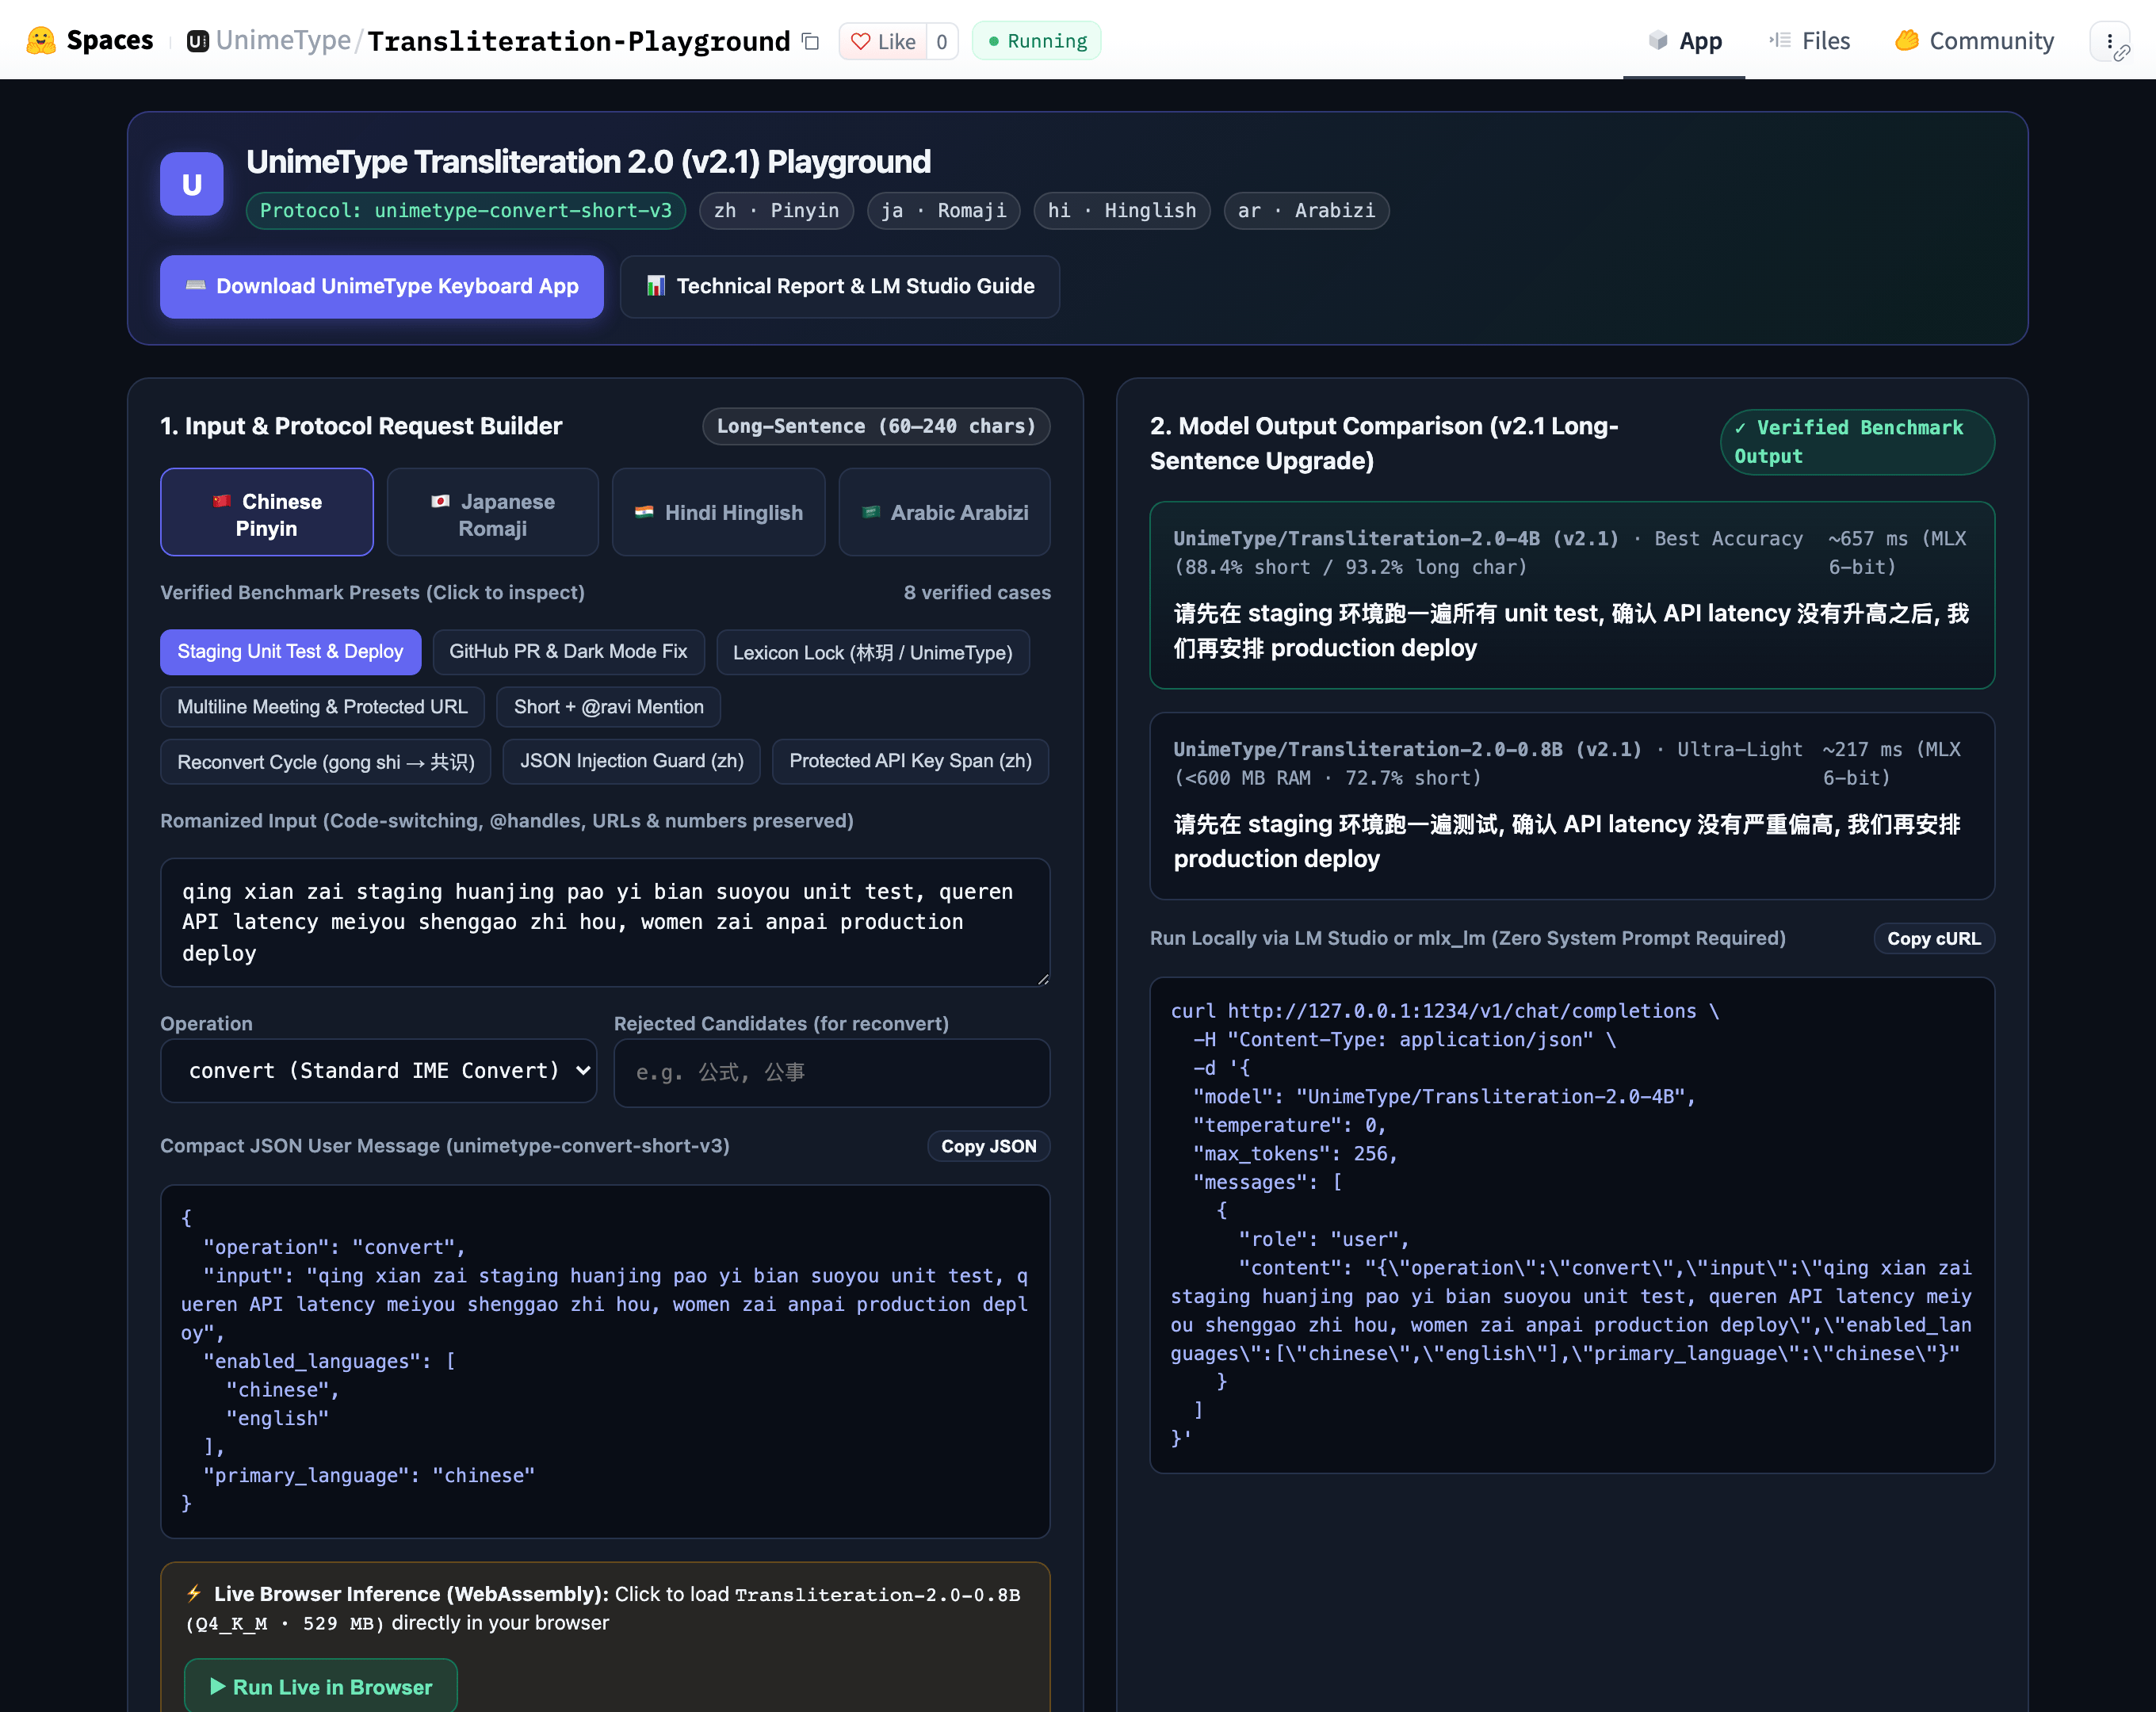
與 v1.0 需要傳入大段英文 System Prompt 不同,Transliteration-2.0 (v2.1) 直接將單行精簡 JSON 作為 user 訊息的 content 傳入,模型會在 assistant 回覆中直接輸出轉換後的純文字:
1. 四語種帶英文技術詞的 convert 標準請求與輸出對照
| 目標語種 | user 訊息 JSON 請求體(content) | 模型直接輸出(assistant) |
|---|---|---|
中文拼音(zh) | {"operation":"convert","input":"mingtian 3pm he @alex review auth-service de PR #412, ranhou deploy dao staging","enabled_languages":["chinese","english"],"primary_language":"chinese"} | 明天 3pm 和 @alex review auth-service 的 PR #412, 然後 deploy 到 staging |
日文羅馬字(ja) | {"operation":"convert","input":"ashita 10am ni Tokyo office de API latency ni tsuite hanashimasu","enabled_languages":["english","japanese"],"primary_language":"japanese","japanese_output_style":"natural"} | 明日 10am に 東京 office で API latency について話します |
印地語 Hinglish(hi) | {"operation":"convert","input":"aaj 4pm meeting hai, please staging logs aur webhook payload bhej dena","enabled_languages":["english","hindi"],"primary_language":"hindi"} | आज 4pm meeting है, please staging logs और webhook payload भेज देना |
阿拉伯語 Arabizi(ar) | {"operation":"convert","input":"ana 3ayez a3raf el build fashal leeh b3d el commit da","enabled_languages":["arabic","english"],"primary_language":"arabic"} | أنا عايز أعرف ال build فشل ليه بعد ال commit ده |
2. 使用 curl 呼叫本機 LM Studio 服務的完整指令
curl http://127.0.0.1:1234/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "UnimeType/Transliteration-2.0-4B",
    "temperature": 0,
    "max_tokens": 256,
    "messages": [
      {
        "role": "user",
        "content": "{\"operation\":\"convert\",\"input\":\"qing bang wo kan yixia auth-service de redirect luoji, mingtian shangwu 10:30 women zai Slack shang duiyixia\",\"enabled_languages\":[\"chinese\",\"english\"],\"primary_language\":\"chinese\"}"
      }
    ]
  }'
3. 進階協定能力(reconvert 換候選與個人詞庫 lexicon 注入)
- 同音詞換一換(
operation: "reconvert"):當片語存在多個合理同音候選(例如「他在哪 / 她在哪 / 它在哪」)時,將"operation"設為"reconvert"並在"rejected_outputs"中傳入已顯示過的候選清單:{"operation":"reconvert","input":"ta zai na","enabled_languages":["chinese","english"],"primary_language":"chinese","rejected_outputs":["他在哪","她在哪"]} - 注入專屬人名或術語保護詞庫(
lexicon):在"lexicon"中傳入最多 24 筆entries,即可在長句轉換中強制鎖定特定人名或產品詞寫法:{"operation":"convert","input":"qing lin yue bang wo kan yixia PR #412","enabled_languages":["chinese","english"],"primary_language":"chinese","lexicon":{"entries":[{"surface":["lin yue"],"preferred":"林玥","do_not_translate":true}]}}
4. 在 macOS 終端機中直接透過 mlx_lm 執行
如果你在 Apple Silicon Mac 上希望不開啟 GUI 直接在終端機測試:
pip install mlx-lm
mlx_lm.generate \
  --model UnimeType/Transliteration-2.0-4B \
  --temp 0.0 \
  --prompt '{"operation":"convert","input":"mingtian jian","enabled_languages":["chinese","english"],"primary_language":"chinese"}'
體驗 UnimeType
無論你希望在本機執行 Transliteration-2.0-0.8B / 4B,還是直接在日常 LINE、Slack 聊天與程式碼編輯器裡使用開箱即用的原地轉換體驗:
- 下載全平台客戶端:前往下載頁面取得 macOS、Windows、iOS 與 Android 客戶端。
- 查閱產品文件:深入瞭解原地替換與宿主相容邊界,請閱讀動作說明、輸入語言與應用程式相容性,或比較即時候選字視窗還是整句 Convert?。
下載 UnimeType支援 iOS、Android、macOS、Windows 與 Linux