當初我們天真地以為,把拼音、羅馬音和 Hinglish 塞進同一個轉寫模型順理成章
剛動手訓練第一版 UnimeType 多語言轉寫模型的時候,我們團隊內部有過一個特別樂觀的判斷:中文拼音、日文 Romaji、印地語 Hinglish 和阿拉伯語 Arabizi,表面上看全都是在美式鍵盤上敲 26 個英文字母,再把把它們還原成各自的母語文字。既然輸入端都是拉丁字母,那放到同一個模型裡無非就是換四套詞表而已。
這個天真的想法大概只維持到了第一輪評測跑完的那天下午。看著滿畫面千奇百怪的錯誤案例,我們才發現這四門語言的拉丁輸入完全是四道不同的題目。它們只是恰好借用了同一塊英文鍵盤,底下把模型絆倒的地方連一點交集都沒有。
拿中文拼音來說,最頭痛的是音節太短、同音字重碼率太高。平時用拉丁字母打字時大家很少敲聲調,單單一個 shi 就可能對應幾十個常用國字。到底是「時間」「事情」「是不是」還是人名裡的「氏」,全得靠前後半句話的語意去判斷。一旦使用者把整句拼音連在一起不打空白鍵(比如 mingtianshangwu),或者在句子中間冷不防塞進一個英文詞(mingtian sync yixia),模型不僅要把拼音音節切對,還得忍住別把 sync 也硬猜成兩個中文字。
到了日文 Romaji,難題一下子變成了「同一句話裡到底該落成哪一種文字」。一句自然的日文往往同時混著漢字、平假名助詞和片假名外來語。使用者輸入一串羅馬字時,模型不光是在把發音換成字元,還得像日本母語者一樣判斷哪個詞該寫成漢字、哪個詞幹後面要留平假名送假名、哪個外來詞該轉成片假名,同時又要把句中真正的英文技術詞(比如 Tokyo office de API latency ni tsuite 裡的 API latency,意為「在東京辦公室聊 API 延遲的事」)原樣留住。最容易翻車的地方恰恰是那些跟英文長得很像的日文助詞,比如原因助詞 node(ので,因為)和並列助詞 to(と,和),稍不注意就會被當成英文的 Node 和介系詞 to。
印地語 Hinglish 則是另一種畫風。它根本沒有一套像漢語拼音那樣統一的標準拼寫表,每個人按自己的口音和習慣在敲拉丁字母,同一個詞有人拼成 kya kar rahe ho(你在忙什麼),有人隨手打成 kya kr rhe ho。更重要的是,在日常印地語聊天裡,英語詞彙和印地語文法是徹底揉碎了混在一起說的。模型面對 Hinglish 時,最關鍵的一步就是克制住自己「哪些詞千萬別改」,更不能像通用聊天模型那樣自作聰明把整句印地語直接翻譯成英文。
而阿拉伯語的 Arabizi 又是另一個世界。因為阿拉伯語裡有好幾個拉丁字母根本表示不出來的喉音和重音,大家在鍵盤上直接拿數字當字母用,比如用 3 代表 ع、用 7 代表 ح、用 2 代表 ء。結果在一句再普通不過的日常訊息裡(比如 sa3a 3 意為「3 點鐘」,或者 b3d el commit v2 意為「在 v2 提交之後」),前一個數字是阿拉伯語單字裡的一個子音字母,後一個數字卻是真真正正的三點鐘或版本號。模型得認出那是個阿拉伯語口語詞,才能決定那個數字到底該變成阿拉伯字母還是保留為阿拉伯數字;再加上埃及、黎凡特、海灣各地的方言拼寫差異極大,同一句話往往有好幾種合理的阿拉伯文寫法。
正因為這四門語言踩的坑完全不同,我們後來在評測模型時徹底放棄了只看一個籠統的「四語平均總分」。哪怕總分再好看,只要中文拼音吞了一個英文變數,或者阿拉伯語把版本號裡的數字吃掉了,落在使用者手底下就是一次實打實的翻車。
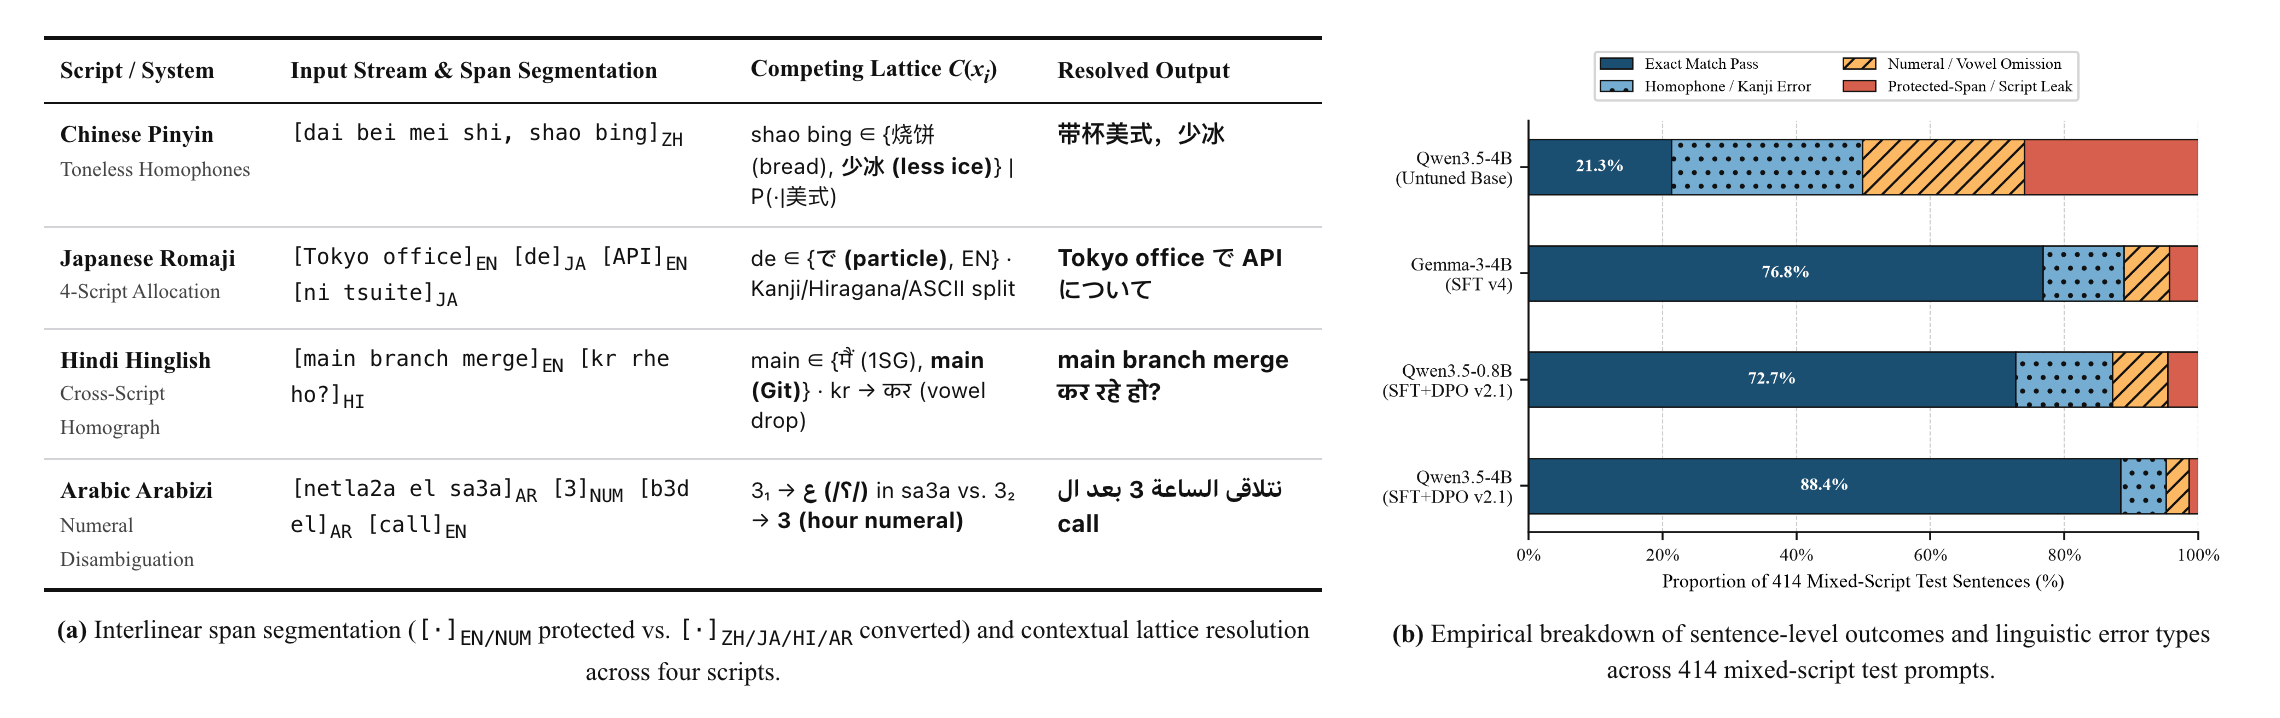
所以我們現在給每一個版本的模型跑分時,都會把中文、日文、印地語和阿拉伯語拆成四個獨立的切片分別記帳,同時單獨檢查英文保留、程式碼變數、多行格式和換候選詞的表現。如果你想看這四個切片在最新資料集和基底模型上的完整實測數據,可以繼續讀我們如何訓練與評測 Transliteration 2.0 模型,或者在輸入語言文件裡查看各語種的具體支援範圍。
下載 UnimeType支援 iOS、Android、macOS、Windows 與 Linux