हमें लगा था कि Hinglish, चीनी Pinyin, जापानी Romaji और Arabizi एक ही जैसी समस्या हैं — जब तक हमने पहला मॉडल टेस्ट नहीं किया
जब हमने पहली बार UnimeType के बहुभाषी Convert मॉडल को ट्रेन करना शुरू किया, तो हमारे मन में एक बेहद आशावादी धारणा थी। हिंदी Hinglish, चीनी Pinyin, जापानी Romaji और अरबी Arabizi — ये चारों स्क्रीन पर बिल्कुल एक ही तरह शुरू होते हैं: कोई व्यक्ति सामान्य अंग्रेज़ी QWERTY कीबोर्ड के सामने बैठता है और गैर-लैटिन लिपि की ध्वनियों को लैटिन अक्षरों (ASCII) में टाइप करता है। हमने सोचा कि अगर इनपुट हमेशा अंग्रेज़ी अक्षरों का फ़ोनेटिक रूप ही है, तो एक ही मॉडल को इन चारों भाषाओं की शब्दावली खिला देना काफ़ी होगा।
हमारी यह खुशफ़हमी ठीक तब तक टिकी जब तक हमारे पहले मूल्यांकन (evaluation run) के एरर लॉग सामने नहीं आ गए। उन गलतियों को पढ़ने पर साफ़ हो गया कि ये चारों लिपियाँ सिर्फ़ कीबोर्ड पर एक जैसी दिखती हैं — अंदर से ये चार बिल्कुल अलग कारणों से टूटती हैं।
1. Hinglish: बिना मानक की स्पेलिंग, गायब होते स्वर और अंग्रेज़ी हमशक्ल शब्द
Hinglish की चुनौती बाकी तीनों से बिल्कुल अलग है। चीनी Pinyin या जापानी Hepburn Romaji के विपरीत, रोज़मर्रा के WhatsApp या Slack चैट में लिखी जाने वाली रोमन हिंदी का कोई एक तयशुदा स्पेलिंग मानक नहीं है:
- अनौपचारिक शॉर्टहैंड और स्वरों का लोप (Vowel-dropping): एक ही वाक्य को कोई
kya kar rahe hoलिखता है, तो कोई तेज़ी में सारे स्वर हटाकरkya kr rhe hoयाsmjh nhi aaya(समझ नहीं आया) टाइप कर देता है। देवनागरी में इसे बदलते समय मॉडल को केवल अक्षर नहीं बदलने होते, बल्कि सही मात्राएँ (ि, ी, ु, ू, े, ै) और संयुक्ताक्षर (आधे अक्षर) भी पूरे वाक्य के व्याकरण से पकड़ने पड़ते हैं। - अंग्रेज़ी और हिंदी के हमशक्ल शब्द (Homographs): शब्द
mainका मतलब हिंदी मेंमैंभी हो सकता है और Git कीmainब्रांच भी;billका मतलबबिलभी है और अंग्रेज़ी काAWS billभी;manaका मतलबमना करनाभी है। - हर वाक्य में कोड-स्विचिंग: भारत के ऑफिस चैट में लगभग हर वाक्य हिंदी व्याकरण और अंग्रेज़ी तकनीकी संज्ञाओं का मिश्रण होता है (
kal subah release notes bhej dena, staging deploy ho gaya hai)। यहाँ आधी जंग तो सिर्फ़ यह तय करने में है कि किन शब्दों को देवनागरी में बदलना है और किन अंग्रेज़ी शब्दों को बिल्कुल नहीं छूना है — और साथ ही मॉडल को इस लालच से रोकना है कि वह हिंदी शब्दों का अंग्रेज़ी में अनुवाद (translation) करने के बजाय केवल उनकी लिपि को देवनागरी में बदले (देखें अंग्रेज़ी कीबोर्ड पर Hinglish टाइपिंग गाइड और बिना कीबोर्ड बदले बहुभाषी टाइपिंग)।
2. चीनी Pinyin: छोटे अक्षरों में छुपे दर्जनों समध्वनि शब्द (Homophones)
चीनी Pinyin में मुख्य सिरदर्द यह है कि बेहद छोटे लैटिन शब्दांशों में दर्जनों अलग-अलग अर्थ वाले अक्षर छुपे होते हैं। रोज़मर्रा की चैट में कोई भी टोन नंबर (1–4) टाइप नहीं करता, इसलिए shi जैसे तीन अक्षरों का टुकड़ा समय, व्यक्ति, शहर या क्रिया के हिसाब से दर्जनों अलग-अलग चीनी अक्षरों से जुड़ सकता है। और जब कोई बिना स्पेस दिए mingtianshangwu लिखता है और बीच में अंग्रेज़ी का शब्द डाल देता है (mingtian sync yixia), तो मॉडल को पूरे वाक्य के संदर्भ से शब्दों की सीमा पहचाननी पड़ती है ताकि sync गलती से चीनी अक्षरों में न बदल जाए।
3. जापानी Romaji: एक ही वाक्य में तीन लिपियों का संतुलन
जापानी Romaji पर आते ही सवाल "कौन-सा समध्वनि शब्द?" से बदलकर "कौन-सी लेखन प्रणाली?" हो जाता है। एक स्वाभाविक जापानी वाक्य में तीन लिपियाँ एक साथ गुँथी होती हैं: मूल शब्दों के लिए Kanji, व्याकरण के कणों (particles) और क्रिया के अंत के लिए Hiragana, और विदेशी शब्दों के लिए Katakana — साथ ही API latency जैसे शब्दों के लिए सीधे अंग्रेज़ी अक्षर। जापानी में मॉडल जहाँ सबसे ज़्यादा फिसलते हैं वह कठिन शब्दावली नहीं है, बल्कि node (ので, यानी "क्योंकि") और to (と, यानी "और") जैसे छोटे रोमन कण हैं, जो देखने में बिल्कुल अंग्रेज़ी के Node रनटाइम और to प्रीपोज़िशन जैसे लगते हैं।
4. अरबी Arabizi: जब अंक खुद अक्षर बन जाते हैं
और फिर आती है Arabizi, जो ASCII अक्षर-समूह के नियमों को ही मोड़ देती है। चूँकि सामान्य लैटिन अक्षरों में अरबी की कई कंठ्य ध्वनियों के लिए कोई अक्षर नहीं है, इसलिए Arabizi लिखने वाले शब्दों के बीच में ही संख्याओं (digits) का उपयोग करते हैं: ع के लिए 3, ح के लिए 7, ء के लिए 2, इत्यादि। इसका मतलब है कि sa3a 3 या b3d el commit v2 जैसी एक ही लाइन में अंक दो बिल्कुल विपरीत भूमिकाएँ निभाते हैं: sa3a (ساعة) और b3d (بعد) के अंदर लिखा 3 अरबी अक्षर ع बनना चाहिए, जबकि अलग से लिखा 3 और v2 संख्या ही रहना चाहिए। ऊपर से मिस्र, लेवांत और खाड़ी देशों की बोलियों में स्वरों के अंतर के कारण कोई भी साधारण नियम-तालिका (rule table) तुरंत विफल हो जाती है।
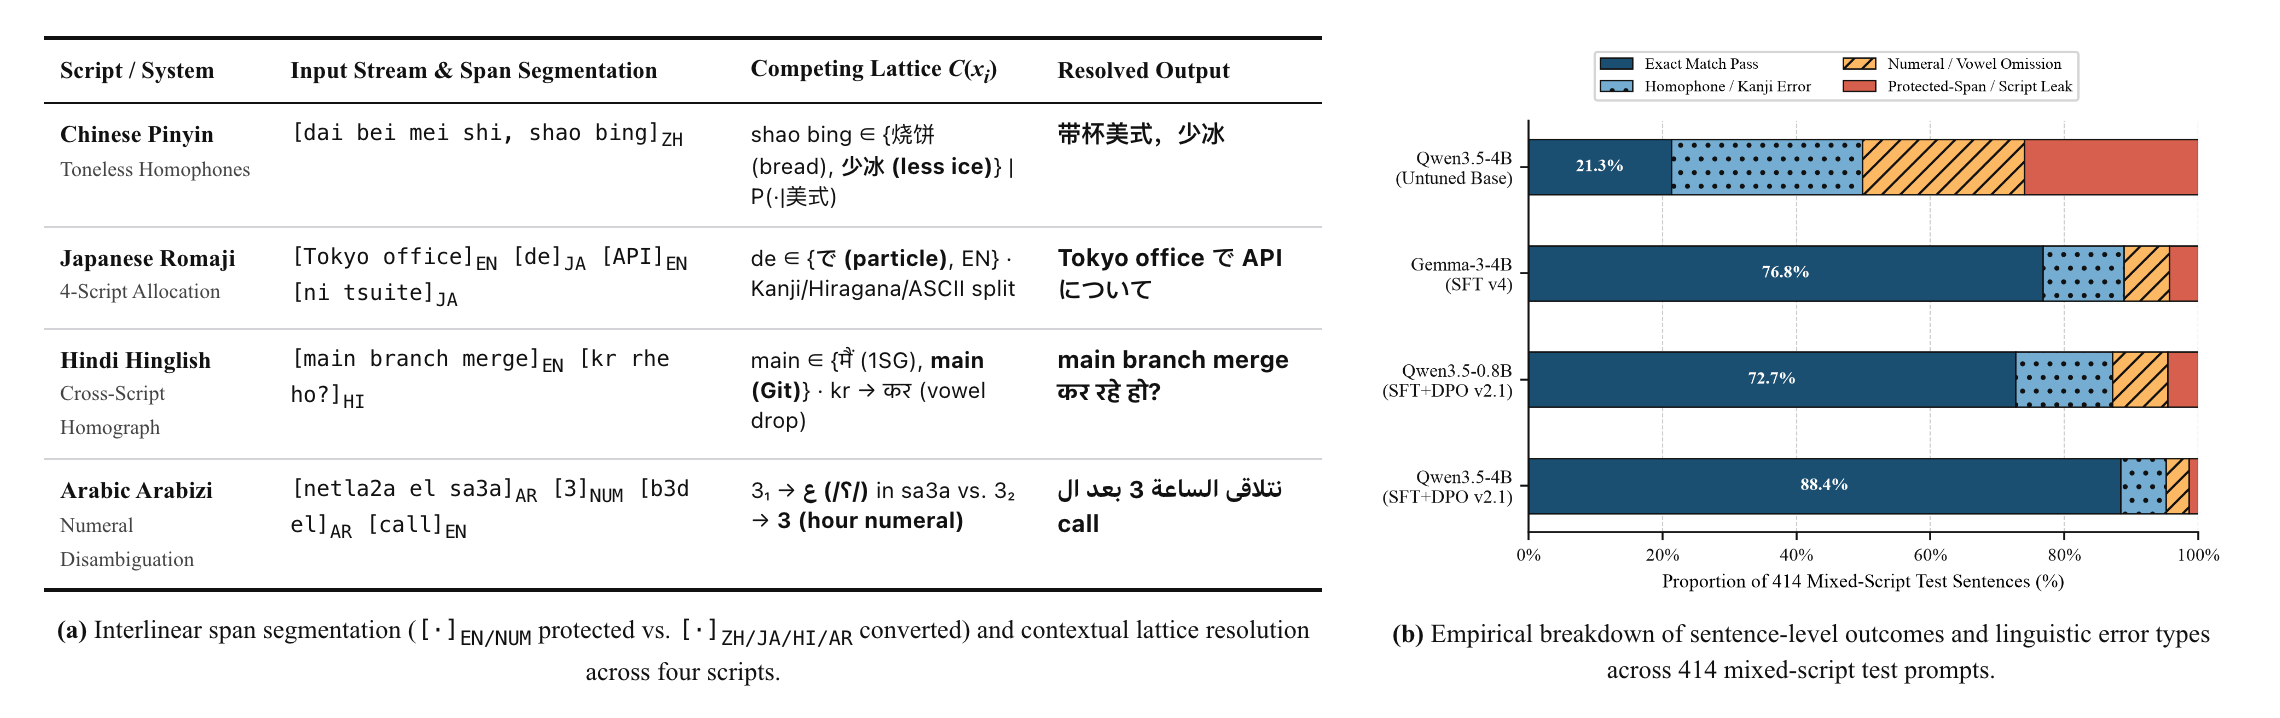
अलग समस्याएँ, अलग मूल्यांकन मानक
यह समझने के बाद कि ये चारों लिपियाँ चार बिल्कुल अलग कारणों से विफल होती हैं, हमने अपने हर मॉडल चेकपॉइंट के मूल्यांकन का तरीका बदल दिया। सभी भाषाओं का एक संयुक्त औसत स्कोर (single combined accuracy) किसी काम का नहीं होता, क्योंकि हिंदी या चीनी में 2% के सुधार के पीछे यह गड़बड़ी छुप सकती है कि मॉडल ने अरबी में वर्ज़न नंबर खाने शुरू कर दिए हैं या Hinglish में main ब्रांच को मैं बनाना शुरू कर दिया है।
आज हम हिंदी, चीनी, जापानी और अरबी को अलग-अलग बेंचमार्क स्लाइस पर परखते हैं — साथ ही सुरक्षित अंग्रेज़ी शब्दों, कोड लिटरल्स, मल्टीलाइन फ़ॉर्मेटिंग और वैकल्पिक उम्मीदवारों के लिए अलग जाँच चलाते हैं। यदि आप हमारे पूरे बेंचमार्क डेटासेट और मूल्यांकन पद्धति को देखना चाहते हैं, तो Transliteration 2.0 के प्रशिक्षण और मूल्यांकन पर हमारी इंजीनियरिंग गाइड पढ़ें, या ऐप में प्रत्येक भाषा के व्यवहार को समझने के लिए इनपुट भाषाएँ और भाषा पैक दस्तावेज़ देखें।
अपना प्लेटफ़ॉर्म चुनेंमौजूदा डाउनलोड और परीक्षण विकल्प देखें।
डाउनलोड देखेंअगली पोस्ट: अंग्रेज़ी कीबोर्ड पर हिंदी टाइप करना आसान है — असली सिरदर्द तब शुरू होता है जब Spacebar आपके अंग्रेज़ी शब्दों को निगल जाता है