ظننا بسذاجة أن العربيزي والبينين والروماجي والهينجليش هي المشكلة نفسها
عندما جلسنا لأول مرة لتدريب نموذج التحويل متعدد اللغات (Convert) في UnimeType، انطلقنا من افتراض متفائل إلى حد السذاجة: العربيزي (Arabizi / Franco-Arabic)، والبينين الصيني (Pinyin)، والروماجي الياباني (Romaji)، والهينجليش الهندي (Hinglish) تبدأ جميعها بالطريقة نفسها تماماً على الشاشة—شخص يجلس أمام لوحة مفاتيح إنجليزية قياسية (QWERTY) ويكتب حروفاً لاتينية لتمثيل لغة تُكتب بنظام حروف غير لاتيني. قلنا لأنفسنا حينها: ما دامت المدخلات دائماً حروف ASCII صوتية، فإن تدريب نموذج واحد يتقن اللغات الأربع هو مجرد مسألة تغذيته بأربع مجموعات من المفردات.
لم يصمد هذا الوهم إلا حتى انتهاء أول جولة تقييم (Evaluation Run). فبمجرد قراءة سجلات الأخطاء اتضح لنا بجلاء أن هذه الأنظمة الأربعة لا تتشابه إلا على سطح لوحة المفاتيح—أما في العمق اللغوي والهندسي، فإنها تفشل بأربع طرق مختلفة تماماً.
1. العربيزي (Arabizi): عندما تتحول الأرقام إلى حروف حلقية وسط الكلمة
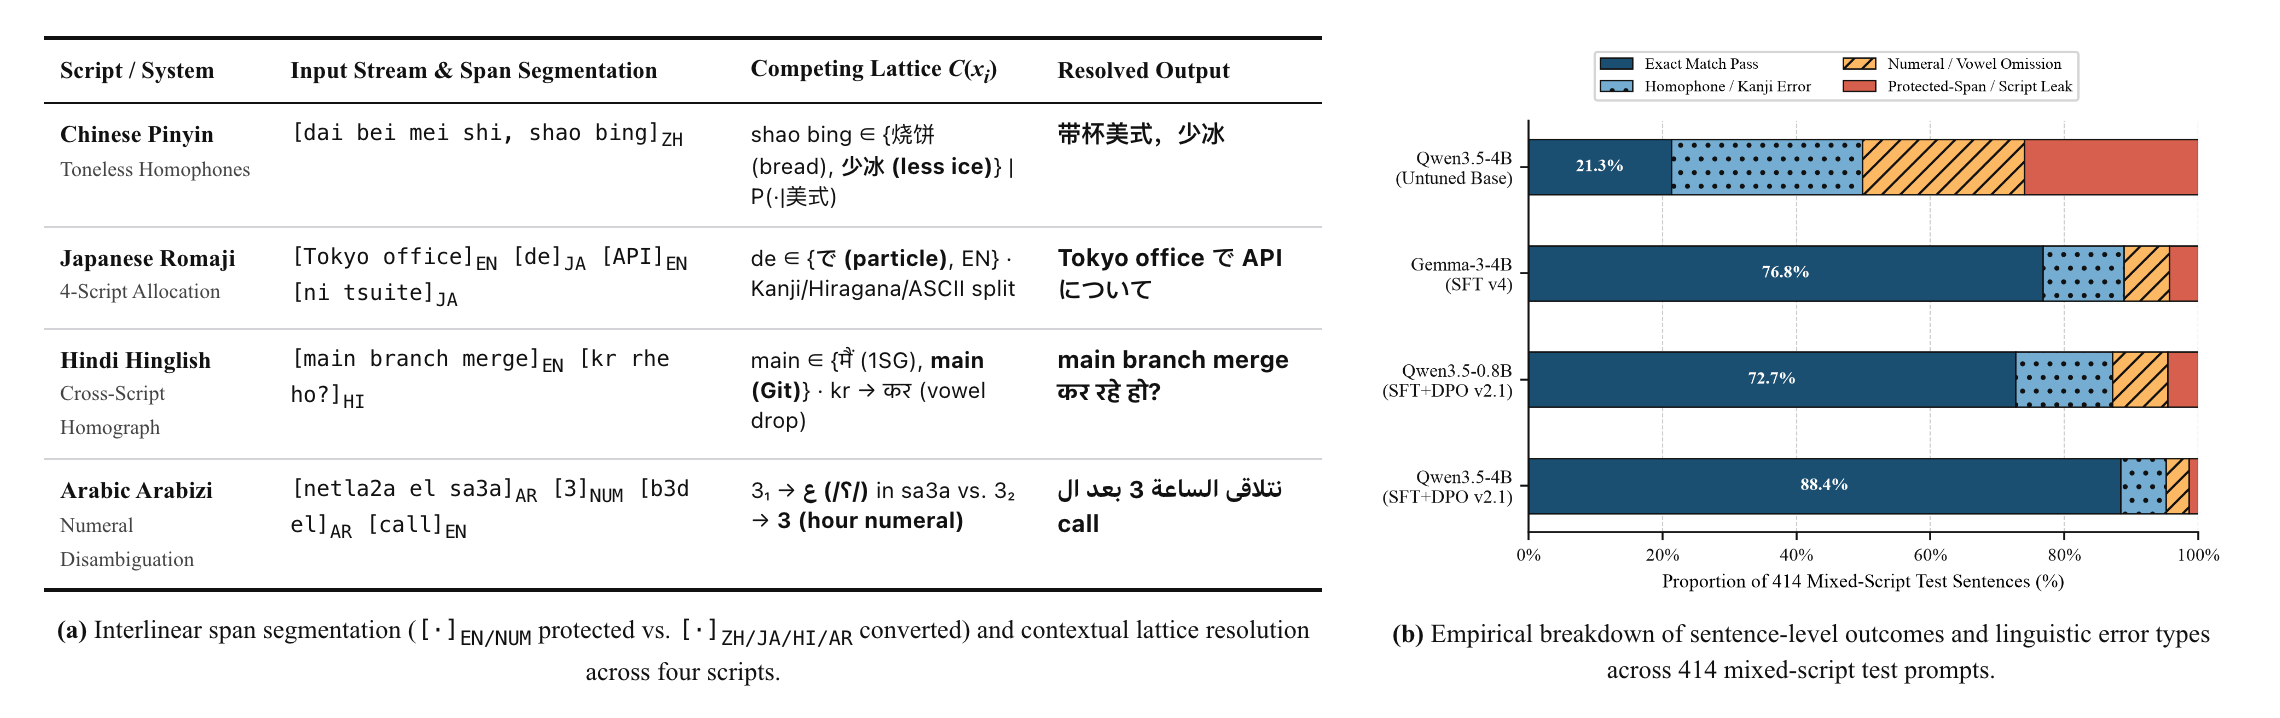
تفرِض الكتابة بالعربيزي تحدياً لا يشبه أي لغة أخرى، لأنها تطوّع جدول رموز ASCII نفسه لتمثيل الأصوات العربية التي لا مقابل لها في الأبجدية اللاتينية. ففي رسائل WhatsApp وSlack وTelegram اليومية في القاهرة أو دبي أو الرياض أو عمّان، يستخدم الكتّاب الأرقام 2, 3, 3', 5, 6, 7, 8, 9 كحروف عربية أصيلة داخل الكلمة:
- الرقم
2يمثّل الهمزة (ء) كما فيnetla2a←نتلاقىأوso2al←سؤال. - الرقم
3يمثّل حرف العين (ع) و3'للغين (غ) كما فيsa3a←ساعةوb3d←بعد. - الرقم
5يمثّل الخاء (خ) كما في5alas←خلاص. - الرقم
7يمثّل الحاء (ح) كما فيme7tag←محتاجأوsa7←صح. - الرقم
9يمثّل الصاد (ص) أو القاف (ق) بحسب المنطقة، و6للطاء (ط).
هذا يعني أن جملة يومية واحدة مثل bokra netla2a el sa3a 7 b3d el commit v2 تحتوي على أرقام تؤدي وظيفتين متناقضتين تماماً: فالرقم 2 داخل netla2a والرقم 3 داخل sa3a وb3d يجب أن يتحولا إلى حروف عربية (نتلاقى، ساعة، بعد)، بينما الرقم 7 في el sa3a 7 يجب أن يبقى رقماً زمنياً (الساعة 7)، وv2 يجب أن يبقى رقم إصدار برمجي دون أي مساس!
ولا يتوقف تعقيد العربيزي عند الأرقام؛ بل يضاف إليه غياب معيار إملائي واحد واختلاف اللهجات بين المصرية والشامية والخليجية مع الفصحى (فكلمة واحدة قد تُكتب khalas أو 5alas، و3ayez أو baddi أو abi)، فضلاً عن الفوضى البصرية الشهيرة لحركة المؤشر ثنائية الاتجاه (BiDi RTL/LTR) عندما تجتمع كلمات عربية ومصطلحات إنجليزية في سطر واحد—وهي المشكلة التي دفعت كثيراً من المبرمجين إلى الكتابة بالعربيزي أو استخدام أدوات قديمة مثل Yamli من الأساس.
2. البينين الصيني (Pinyin): كثافة هائلة للمشتركات اللفظية في مقاطع قصيرة
عند الانتقال إلى البينين الصيني، يختفي تحدي الأرقام ليظهر صداع من نوع آخر: الكثافة الشديدة للكلمات المتشابهة صوتياً (Homophones). لا أحد يكتب أرقام النغمات الصوتية في المحادثات اليومية، لذا فإن مقطعاً من ثلاثة حروف مثل shi يمكن أن يقابل عشرات المقاطع الصينية الشائعة بحسب سياق الجملة الكامل. وعندما يكتب المستخدم سلسلة متصلة مع فعل إنجليزي في المنتصف، يجب على النموذج تقسيم المقاطع بدقة مع ترك الكلمة الإنجليزية دون تحويل.
3. الروماجي الياباني (Romaji): ثلاثة أنظمة كتابة داخل الجملة الواحدة
في اليابانية، يتحول السؤال من «أي كلمة مقصودة؟» إلى «أي نظام كتابة يجب استخدامه؟». فالجملة اليابانية الطبيعية تنسج ثلاثة أنظمة معاً: الكانجي (Kanji) لجذور الكلمات، والهيراغانا (Hiragana) للأدوات النحوية وتصريفات الأفعال، والكاتاكانا (Katakana) للكلمات الدخيلة—إلى جانب الحروف اللاتينية لمصطلحات مثل API latency. وأكثر ما يوقع النماذج في الخطأ هو الأدوات النحوية القصيرة مثل node (ので بمعنى «لأن») وto (と بمعنى «وَ»)، التي تتطابق حرفياً مع بيئة التشغيل Node وحرف الجر الإنجليزي to ما لم يقرأ النموذج التركيب النحوي للجملة كاملة.
4. الهينجليش الهندي (Hinglish): إملاء مرن وتداخل مستمر مع الإنجليزية
أما الهينجليش فيحمل تحدياً رابعاً: غياب الإملاء القياسي الموحد في المحادثات اليومية مع التداخل الكثيف للمفردات الإنجليزية في كل جملة عمل. هنا تكمن نصف المعركة في تحديد الكلمات الإنجليزية التي يجب ألا يلمسها النموذج، ومنعه من ترجمة الجملة الهندية إلى الإنجليزية بدلاً من تحويل حروفها إلى خط الديفاناغاري (Devanagari).
كيف غيّر ذلك طريقة تقييمنا للنماذج؟
إدراكنا أن هذه الأنظمة الأربعة تفشل لأربعة أسباب مختلفة جذرياً غيّر طريقة تقييمنا لكل نسخة من النموذج. فالاعتماد على رقم دقة واحد مجمّع لكل اللغات أمر مضلل تماماً، لأن تحسناً طفيفاً في الصينية قد يخفي وراءه تراجعاً خطيراً يبدأ فيه النموذج بابتلاع أرقام الساعات والإصدارات في العربيزي أو إبقاء الأدوات النحوية اليابانية بالحروف اللاتينية.
اليوم نقيم العربية والصينية واليابانية والهندية عبر شرائح اختبار (Benchmarks) مستقلة تماماً، إلى جانب اختبارات صارمة لحماية المصطلحات الإنجليزية البرمجية، والأرقام الزمنية، والأسطر المتعددة، والخيارات البديلة. إذا أردت الاطلاع على تفاصيل منهجية التقييم وأرقام الأداء، يمكنك قراءة دليلنا الهندسي لتدريب وتقييم نماذج Transliteration 2.0، أو مراجعة صفحة لغات الإدخال ومقالتنا حول الكتابة متعددة اللغات دون تبديل لوحة المفاتيح.
اختر منصتكاطّلع على خيارات التنزيل والاختبار الحالية.
عرض التنزيلاتالمقال التالي: لماذا ينساب الكلام بين العربية والإنجليزية بسهولة، بينما تتعثر الكتابة على لوحة المفاتيح؟