日本語のローマ字、中国語のピンイン、Hinglish、Arabizi——「どれも英字から母語文字への変換でしょ?」と甘く見ていた私たちが最初の評価テストで打ちのめされた話
UnimeType の多言語変換モデル(Convert モデル)の学習を始めた当初、私たちは今思えばかなり楽観的な前提に立っていました。日本語のローマ字(Romaji)、中国語のピンイン(Pinyin)、ヒンディー語の Hinglish、アラビア語の Arabizi は、画面上ではどれもまったく同じところから始まります。標準的な QWERTY 英字キーボードに向かい、ラテン文字(ASCII)を叩いて非ラテン文字の言葉を表すという点です。「入力がどれも ASCII の表音文字列なら、4言語分の語彙データを混ぜて学習させれば1つのモデルで同じように解けるはずだ」と考えていたのです。
その甘い幻想は、最初の評価ベンチマーク(Evaluation)の結果が返ってきた瞬間に打ち砕かれました。エラーログを1行ずつ読み解いていくと、この4つの言語は「キーボードの上で英字に見える」という点だけが共通していて、裏側でモデルが直面している言語学的な難所は4つともまったく別次元だったのです。
1. 日本語のローマ字(Romaji):1文に4つの文字体系が同居し、助詞と英単語が衝突する
日本語話者にとっては当たり前すぎて意識しないことですが、日本語のローマ字一括変換は、他のどの言語とも違う独自の構造を持っています。自然な日本語の1文には、漢字(語幹・名詞)、ひらがな(助詞・送り仮名)、カタカナ(外来語)、そして **API や staging のような半角英数(ASCII)**という4種類もの文字体系が同時に混ざり合います。
さらに実際の評価でモデルを最も苦しめたのは、以下の4つの日本語特有の罠でした。
- 助詞の発音と表記のズレ(
wa→は、o/wo→を、e→へ):ローマ字入力ではkyou waと打つかkyou haと打つかが人によって揺れます。さらにnode(「〜なので」の助詞ので)やto(助詞のと)は、英語のランタイム名Nodeや前置詞toと綴りが1文字違わず一致します。前後の文節の文法構造を正確に読まなければ、モデルは日本語の助詞を英単語と勘違いしてラテン文字のまま残してしまいます。 - 促音(
tt/kk/ss→っ)と撥音(n/nn→ん)の境界:itte(行って/言って)やkakkou(格好)、あるいはスペースなしで続けて打たれたashitatokyodeのような文字列から、どこが単語の切れ目でどこが促音・長音なのかを切り出す必要があります。 - 文脈依存の同音異義語:
hashi(橋/箸/端)やkoushou(交渉/考証/公称)、seisan(精算/生産)のように、文全体のテーマを見なければ漢字が決まらない語が頻出します。 - 「カタカナ語にすべき外来語」と「半角英数のまま残すべき技術用語」の境界:たとえば
ashita 10am ni Tokyo office de API latency ni tsuite hanashimasuという入力に対して、一般的な外来語はカタカナにしつつ、エンジニアが意図して打ったAPI latencyやofficeは勝手にカタカナ(エーピーアイ・レイテンシー)にせず半角英数のまま保持しなければなりません。
2. 中国語のピンイン(Pinyin):声調なしの超高密度な同音異義語パズル
一方、中国語のピンインに移ると、問題の性質は「どの文字体系か?」から「どの同音異義語か?」へと一変します。
日常のチャットで声調番号(1〜4)を打つ人はいません。そのため、shi のようなわずか3文字の音節だけで、時間(時)、人(氏)、都市(市)、動詞(是/試)、名詞(事/実)など何十もの常用漢字にマッピングされます。しかもユーザーは mingtianshangwu のようにスペースを入れずに連続で打つことが多く、その途中に突然 mingtian sync yixia と英語の動詞を挟みます。モデルは文全体の意味からピンインの音節の切れ目を推論しつつ、sync を無理やり中国語の当て字に変換してしまわないよう踏みとどまらなければなりません。
3. ヒンディー語の Hinglish:正書法のない自由な綴りと、「翻訳」への暴走を防ぐ戦い
Hinglish(ローマ字表記のヒンディー語)は、さらに別の難しさを突きつけてきます。日本のヘボン式・訓令式ローマ字や中国語のピンインには明確な綴りの規格がありますが、日常の Hinglish には統一されたスペル規則が存在しません。
同じフレーズでも、ある人は kya kar rahe ho と打ち、別の人は母音を省略して kya kr rhe ho と打ちます。さらにインドの職場チャットでは、kal subah release notes bhej dena のようにヒンディー語の文法の中に英語の名詞が深く溶け込んでいます。ここで未調整のモデルを使うと、ヒンディー語をデーヴァナーガリー文字へ「音訳(Transliterate)」する代わりに、文全体を英語へ「翻訳(Translate)」してしまうという事故が頻発しました。どの英単語をそのまま残し、どのヒンディー語だけをデーヴァナーガリー文字(कल सुबह release notes भेज देना)に置き換えるかを制御するのが最大の勝負どころでした。
4. アラビア語の Arabizi:数字の「3」や「7」が文字にも数字にもなる世界
そして最も衝撃的だったのが、アラビア語圏で使われる Arabizi(フランコ・アラビック)です。標準的なラテン文字のアルファベットには、アラビア語特有の咽頭音や声門閉鎖音を表す文字がありません。そのため Arabizi の書き手は、単語の中にアラビア数字を混ぜて子音を表します。たとえば 3 は ع(アイン)、7 は ح(ハー)、2 は ء(ハムザ)といった具合です。
すると、sa3a 3(3時)や b3d el commit v2(commit v2 の後で)という1行の中に、まったく逆の役割を持つ数字が同居することになります。sa3a(ساعة)や b3d(بعد)の単語の中にある 3 はアラビア文字の ع に変換しなければなりませんが、単独の 3 や v2 の数字はそのまま算用数字として残さなければなりません。さらにエジプト、レバント、湾岸諸国など地域ごとの方言綴りの違いも加わるため、単純なルールベースの置換テーブルでは太刀打ちできませんでした。
これら4つの言語が「4つのまったく異なる理由で失敗する」という事実を突きつけられたことで、私たちのモデルの学習・評価パイプラインは根本から変わりました。
全言語を合算した1つの平均スコアだけを見るのは無意味どころか有害です。なぜなら、中国語のスコアが上がった裏で、「アラビア語がバージョン番号の数字を文字に誤変換するようになった」「日本語の助詞 node が英語の Node として取り残されるようになった」という退行(リグレッション)が簡単に隠れてしまうからです。
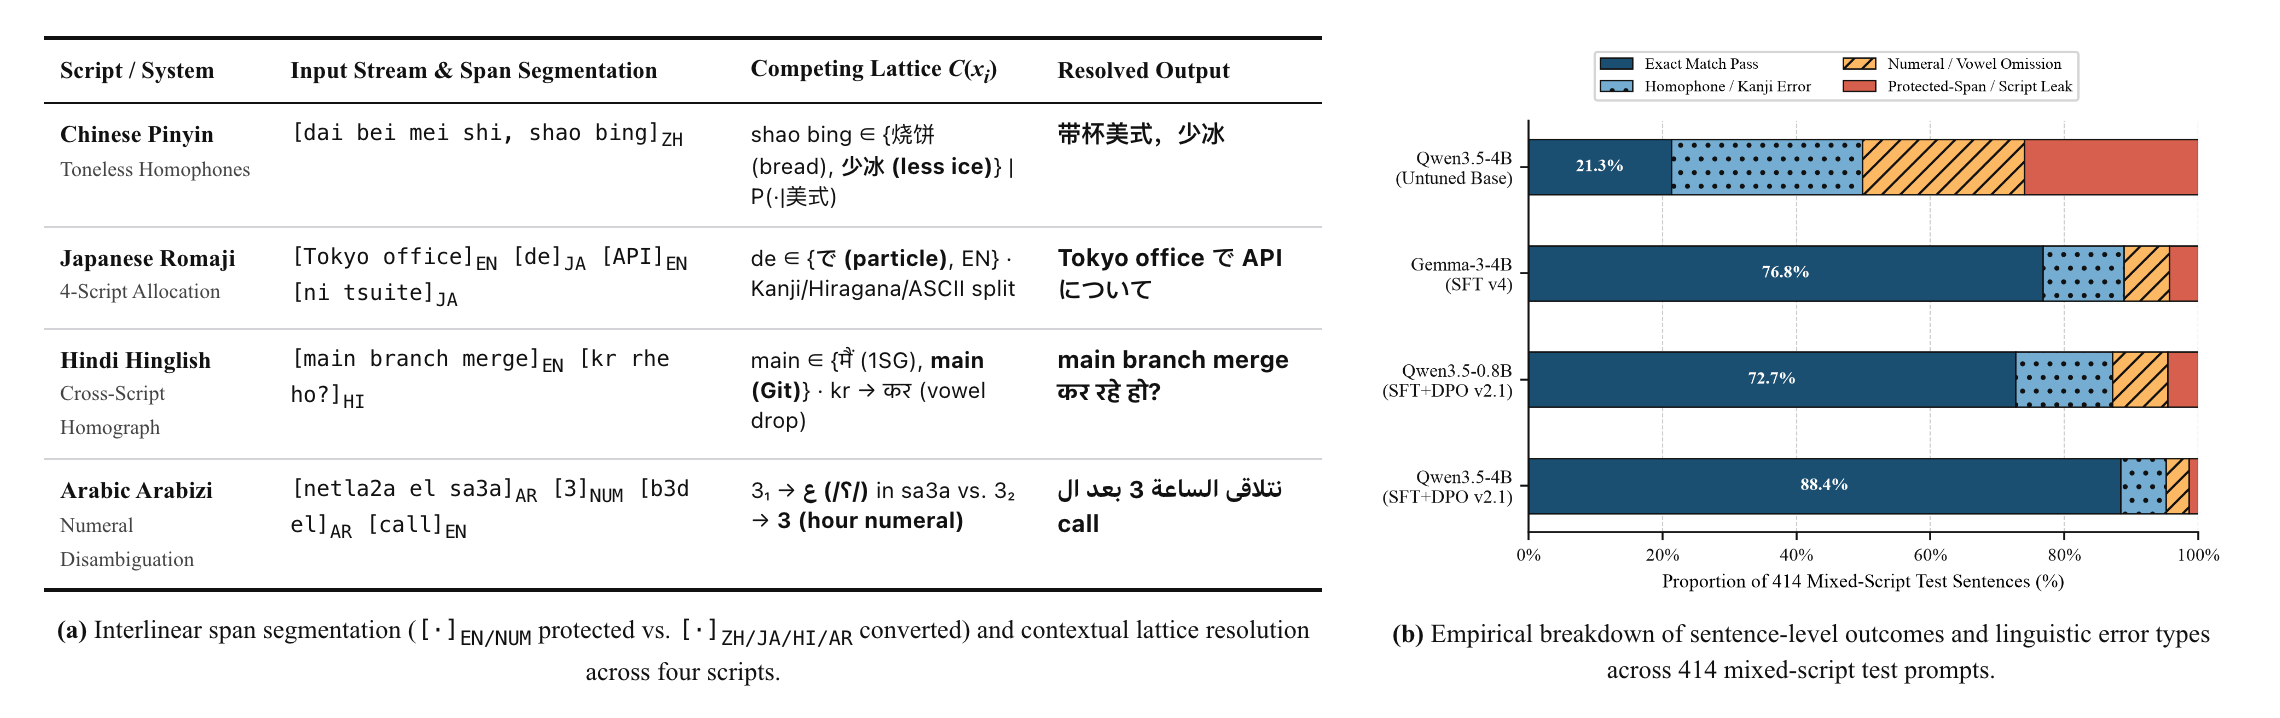
現在、私たちは日本語、中国語、ヒンディー語、アラビア語をそれぞれ独立したベンチマークスライスで評価し、さらに「保護すべき英語の技術用語・コード片」「複数行のフォーマット保持」「同音異義語の別候補(reconvert)」を個別にテストしています。具体的なベンチマークの数値やデータセット設計、Mac / PC でのローカル実行手順については、Transliteration 2.0 モデルの学習・評価エンジニアリング解説(英語)で詳しく公開しています。また、アプリ内での各言語の振る舞いについては入力言語のドキュメントもあわせてご覧ください。
プラットフォームを選択iOS・Android・macOS・Windows・Linux に対応